
上周,我们在 Claude Code 中发布了动态工作流。现在,Claude 可以随时为自己编写一套智能体运行框架(harness),专门适配手头的任务。
Claude Code 默认的运行框架虽然为编程而设计,但也适用于许多其他任务,因为事实证明,很多任务与编程任务颇为相似。不过,对于某些类型的任务,我们过去必须在 Claude Code 之上构建专用框架,才能获得最佳表现,例如研究、安全分析、智能体团队以及代码审查。
工作流让你能够动态创建运行框架,使 Claude 在 Claude Code 内部原生解决这些问题,以及更多问题。你还可以与他人分享并复用这些工作流。
本文将介绍我初步使用工作流的经验和心得,帮助你充分发挥它的作用。
不过,最佳实践仍在发展中!动态工作流通常会消耗更多 token,因此需要认真考虑何时使用、如何使用。注:本文也刊登于 Claude 博客。
提示词示例
在深入技术细节之前,我想先给出一些提示词示例,帮助你思考工作流的各种可能性:
- “这个测试大概每运行 50 次就失败一次。建立一个工作流来复现问题、提出假设,并在 worktree 中以对抗方式检验这些假设。/goal 在有一个假设被证实之前,不要停止。”
- “使用工作流查看我最近 50 次会话,找出我反复提出的纠正意见,把那些重复出现的问题转化成 CLAUDE.md 规则。”
- “使用工作流梳理 Slack 中过去六个月的 #incidents 频道,找出反复出现、却一直没人创建工单的根本原因。”
- “拿我的商业计划运行一个工作流,让不同智能体分别从投资人、客户和竞争对手的角度挑出其中的问题。”
- “这个文件夹里有 80 份简历,使用工作流按后端岗位要求进行排序,并复核前十名。使用 AskUserQuestion 工具向我提问,确定评判标准。”
- “我需要给这个 CLI 工具起个名字。使用工作流头脑风暴出一批候选名,再通过锦标赛选出前三名。”
- “使用工作流,把所有地方的 User 模型都重命名为 Account。”
- “检查我的博客草稿,使用工作流对照代码库核实每一项技术论断,我不想发布任何错误内容。”
动态工作流如何运行
动态工作流会执行一个 JavaScript 文件,其中包含一些用于创建和协调子智能体的特殊函数:
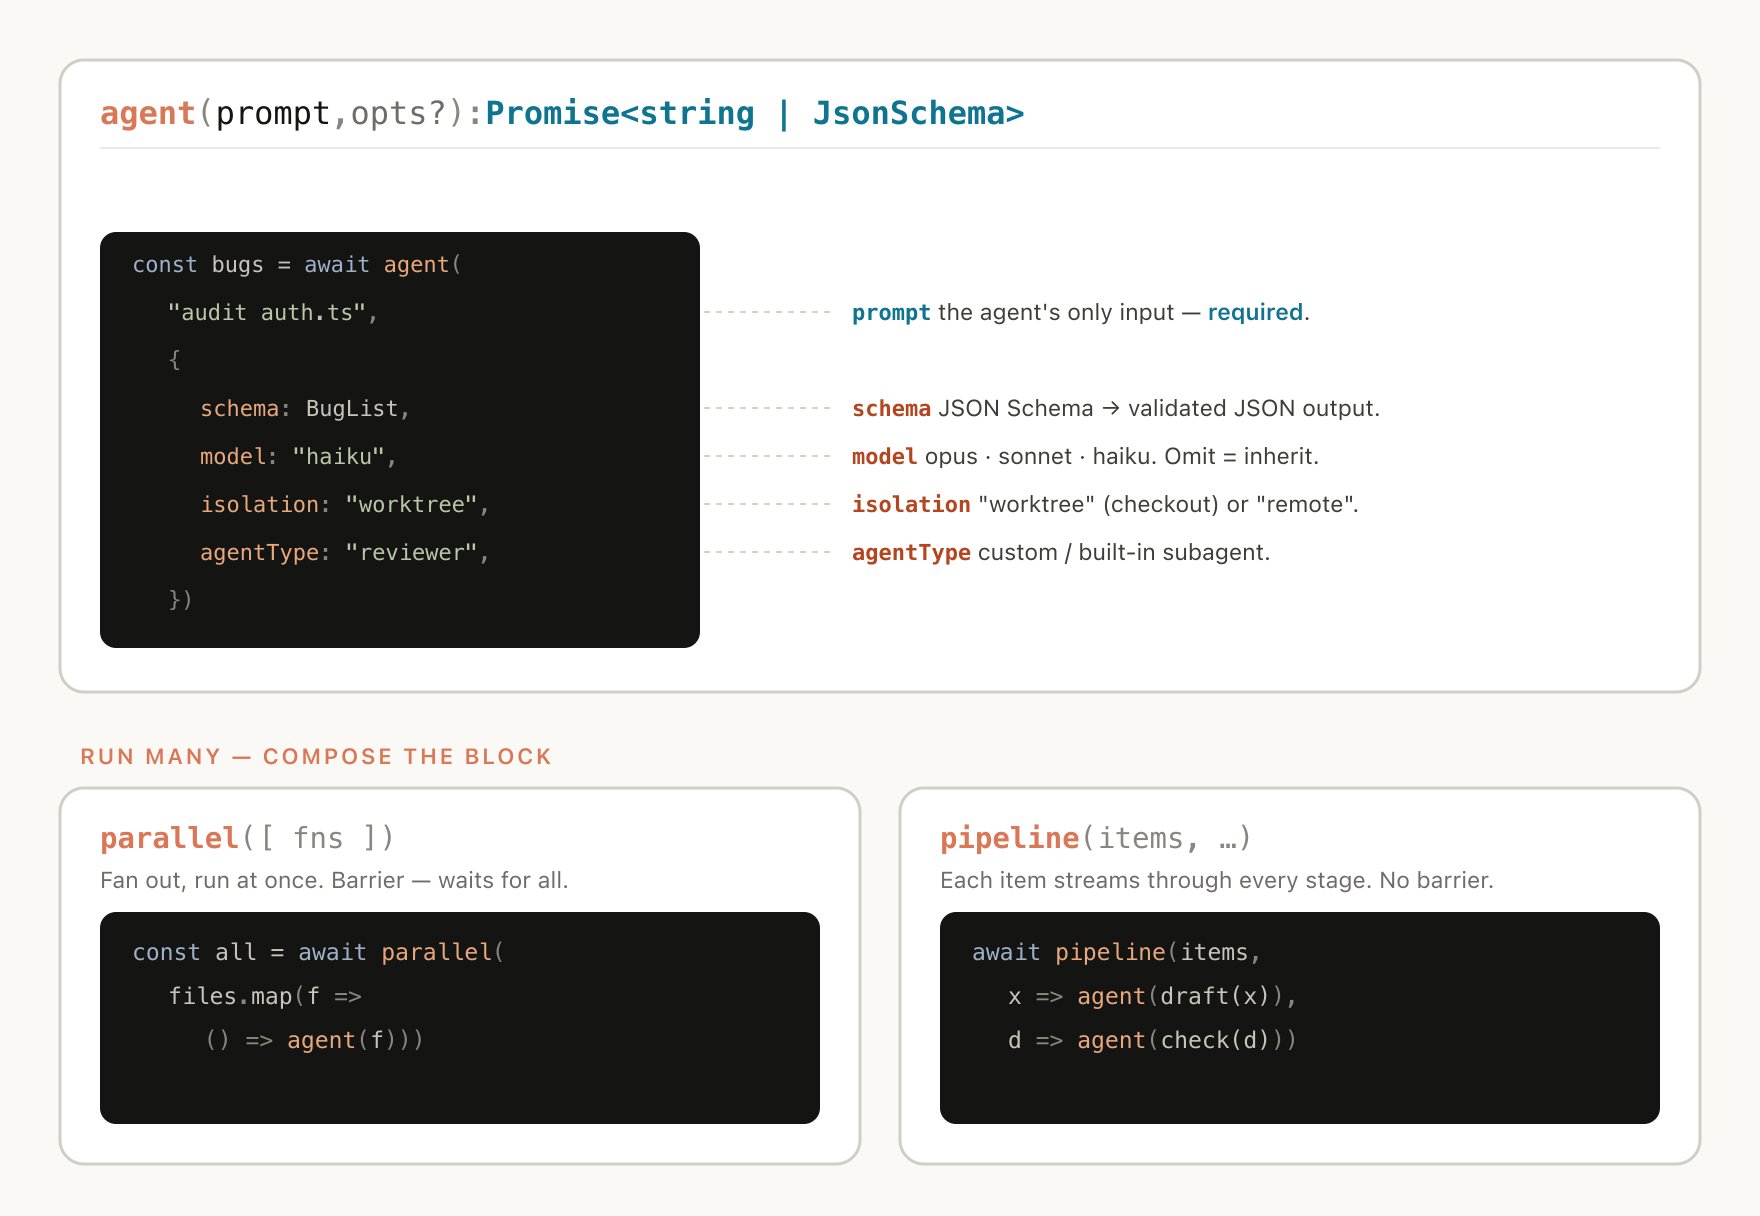
动态工作流也提供 JSON、Math 和 Array 等标准 JavaScript 功能,帮助处理数据。
一个特别有用的能力是:动态工作流可以决定智能体使用哪个模型,以及子智能体是否在各自独立的 worktree 中运行,从而让 Claude 选择任务所需的智能水平和隔离方式。
如果工作流因用户操作或退出终端等原因而中断,恢复会话后,工作流可以从中断处继续。
为什么需要动态工作流
当你让默认的 Claude Code 运行框架执行任务时,它需要在同一个上下文窗口中同时进行规划和执行。对于许多编程任务,这种方式非常有效;但在耗时很长、大规模并行,或高度结构化的对抗性任务中,它有时会失效。
这是因为,Claude 在单一上下文窗口中处理复杂任务的时间越长,就越容易出现以下几类问题:
- 智能体偷懒(Agentic laziness):面对特别复杂、包含多个部分的任务,Claude 可能在完成之前就停止,只取得部分进展便宣布任务完成。例如,安全审查中共有 50 项,却只处理了 20 项。
- 偏爱自身结果的偏差(Self-preferential bias):Claude 倾向于偏爱自己得出的结果或发现,尤其是在要求它核验这些结果,或根据评判标准对结果作出判断时。
- 目标漂移(Goal drift):经过多轮交互后,执行内容逐渐偏离原始目标,尤其是在上下文压缩之后。每次摘要都会损失信息,边界情况的要求或“不要做 X”之类的限制可能因此丢失。
创建工作流有助于应对这些问题:它负责协调彼此独立的 Claude 实例,每个实例都有自己的上下文窗口,以及明确、独立的目标。
动态工作流与静态工作流
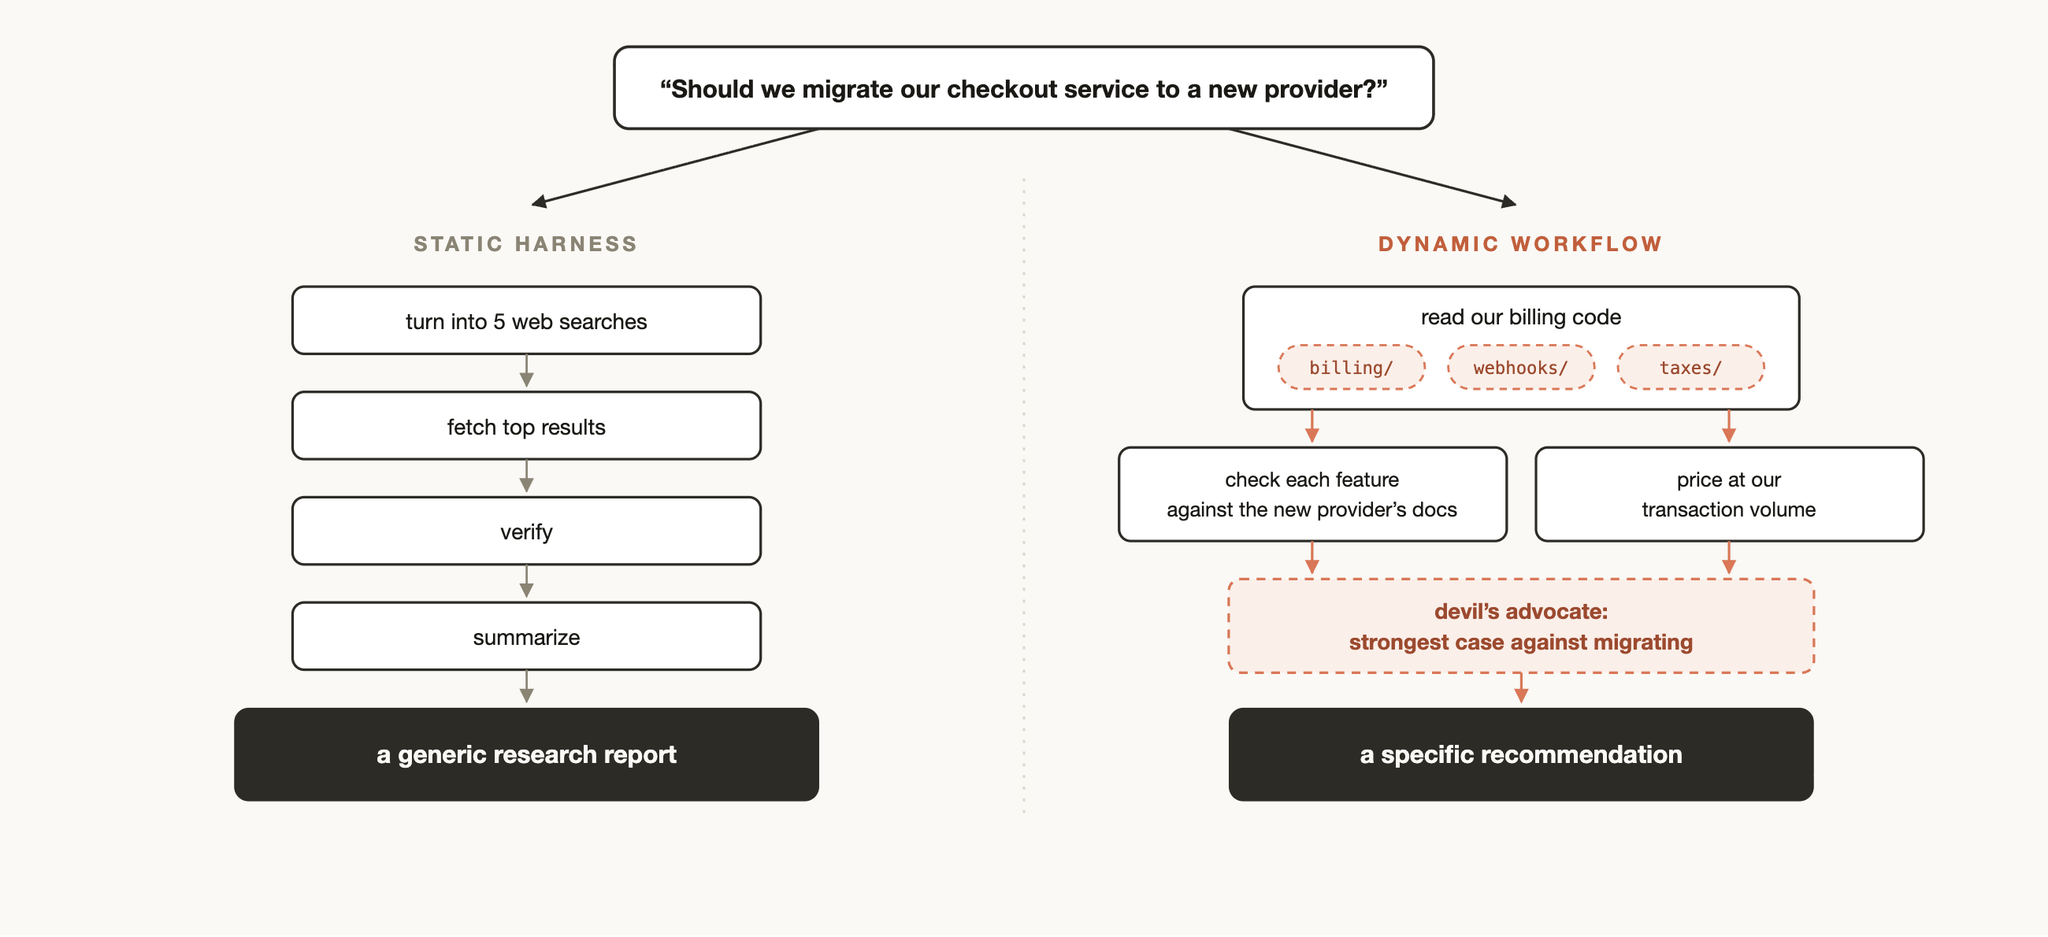
你可能已经使用 Claude Agent SDK 或 claude -p 创建过静态工作流,将多个 Claude Code 实例协调起来。
但静态工作流必须适用于各种边界情况,所以通常更为通用。有了 Claude Opus 4.8 和动态工作流,Claude 现在已经足够聪明,能够为你的使用场景量身编写一套运行框架。
动态工作流的实用模式
只要让 Claude 创建一个动态工作流,就可以开始使用;你也可以使用触发词“ultracode”,确保 Claude Code 创建工作流。
不过,建立对动态工作流运行方式的理解,有助于判断何时该使用它,以及如何通过提示词引导 Claude。
Claude 在构建工作流时,可能会使用并组合以下几种常见模式:
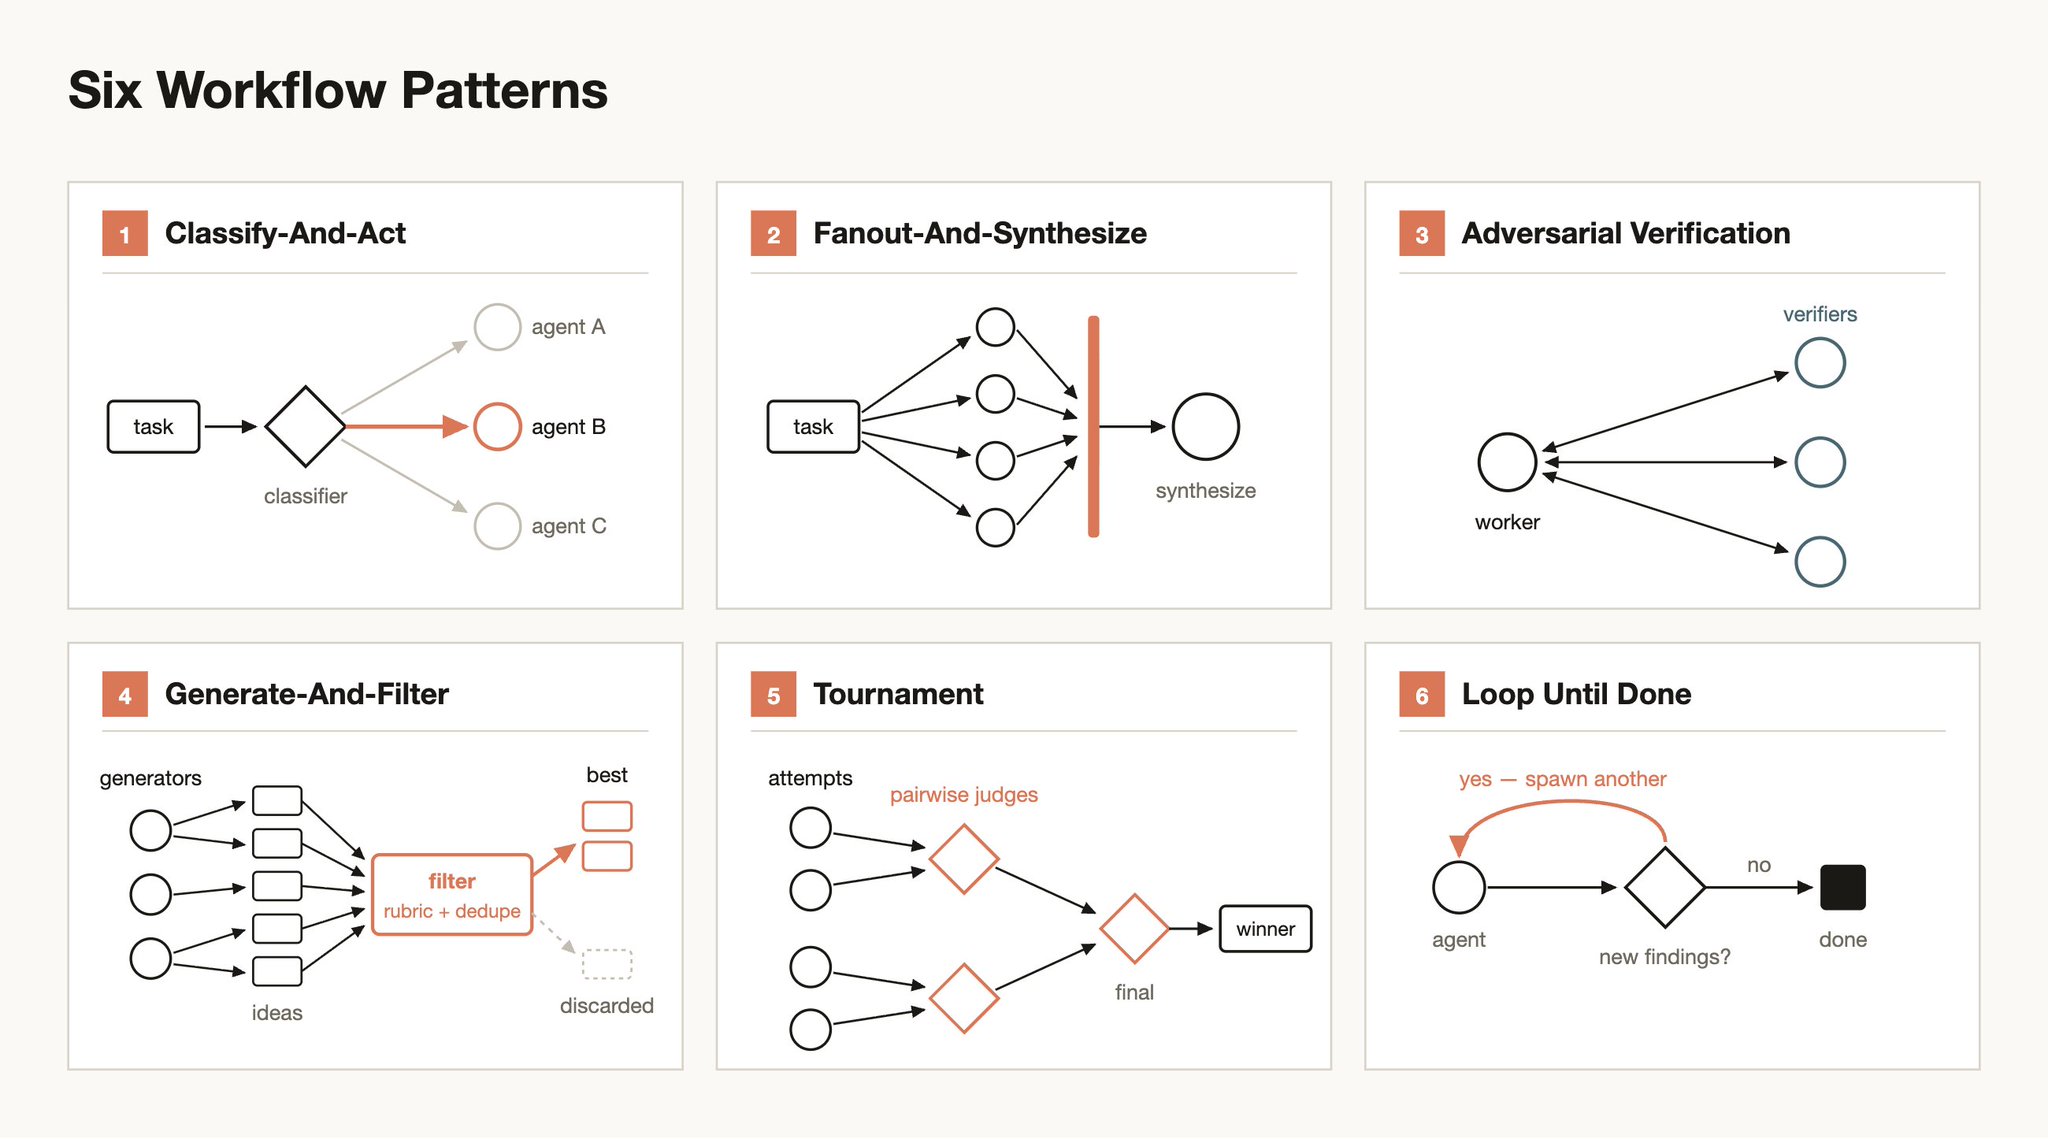
分类后行动(Classify-and-act)
使用分类智能体判断任务类型,再根据任务路由到不同的智能体或执行方式。也可以在最后使用分类器来决定输出。
并行展开后综合(Fan-out-and-synthesize)
将任务拆分成许多较小的步骤,每一步交给一个智能体处理,最后综合结果。当任务包含大量小步骤,或每一步都适合使用独立、干净的上下文窗口,以免相互干扰或污染时,这种模式尤其有用。综合步骤是一道同步屏障:它会等待所有并行智能体完成,再把它们的结构化输出合并为一个结果。
对抗式核验(Adversarial verification)
为每个创建出的智能体,再创建一个独立智能体,依据评判标准或具体条件,对前者的输出进行对抗式核验。
生成后筛选(Generate-and-filter)
围绕一个主题生成多个想法,再根据评判标准或验证结果进行筛选、去重,只保留质量最高且经过检验的想法。
锦标赛(Tournament)
不拆分工作,而是让智能体相互竞争。创建 N 个智能体,让它们用不同方法尝试完成同一个任务,再通过提示词或模型,让评审智能体对结果进行两两比较,直到选出胜者。
循环直到完成(Loop until done)
对于工作量未知的任务,不预先固定执行轮数,而是循环创建智能体,直到满足停止条件,例如不再有新发现,或者日志中不再出现错误。
使用场景
不妨创造性地思考何时、如何让 Claude Code 创建动态工作流。我发现,在非技术工作中,工作流有时甚至更有用。
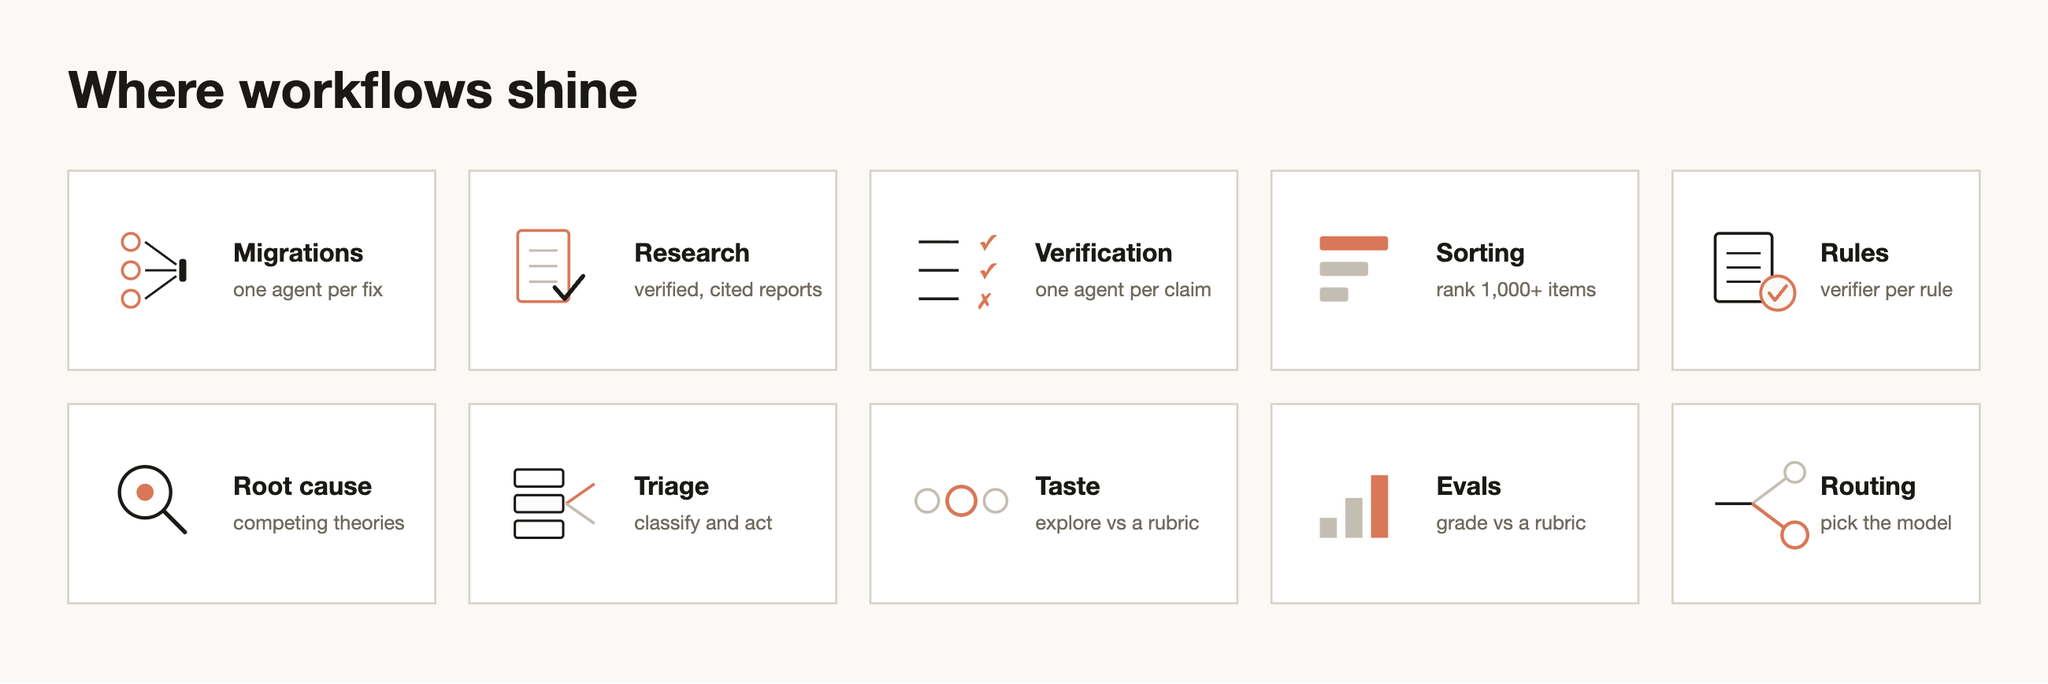
迁移与重构
Bun 借助工作流完成了从 Zig 到 Rust 的重写。具体做法可以阅读 Jarred 的 X 帖文串。
关键是把任务拆成一系列需要处理的步骤,例如调用点、失败的测试、模块等。为每项修复创建一个在 worktree 中工作的子智能体,再让另一个智能体进行对抗式审查,最后合并结果。可以考虑告诉智能体不要使用耗费大量资源的命令,这样就能在不耗尽本机资源的前提下,尽可能提高并行度。
深度研究
我们在 Claude Code 中发布了一个使用动态工作流的深度研究技能(/deep-research)。具体来说,它会并行开展网页搜索、获取来源、对来源中的论断进行对抗式核验,最后综合成一份附有引用的报告。
这种研究并不局限于网页搜索。例如,你可以让 Claude 根据 Slack 中的上下文整理状态报告,或深入探索代码库,研究某个功能的工作原理。
深度核验
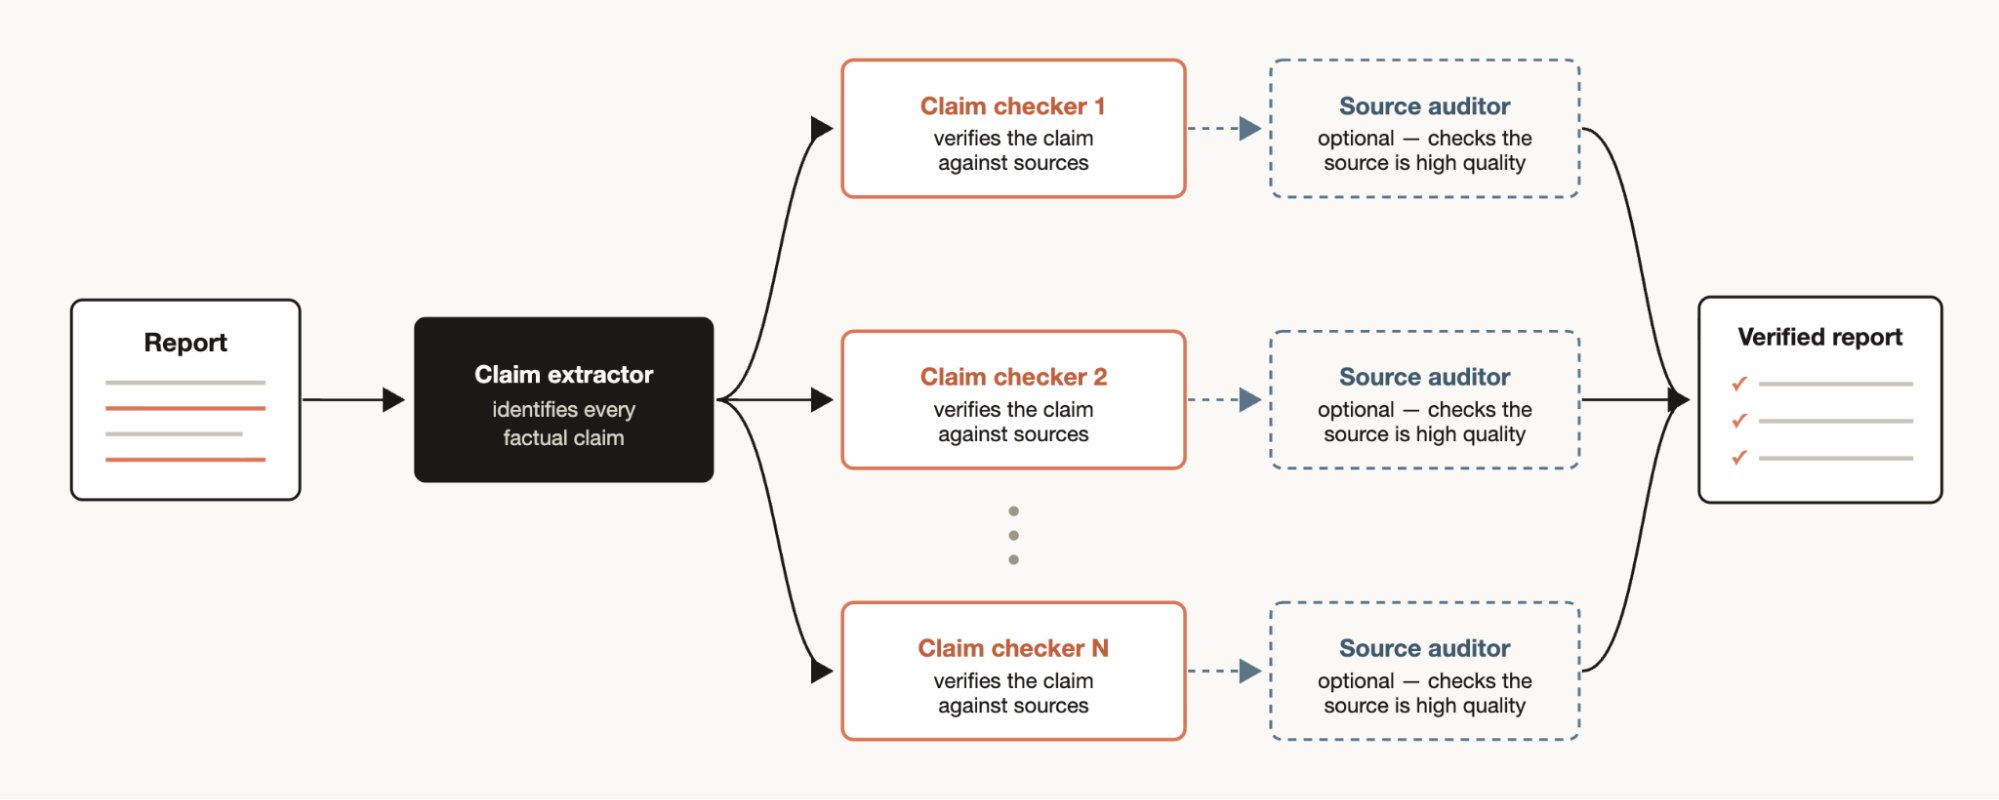
另一方面,如果你有一份报告,想要核实其中的每一项事实论断并找到来源,可以创建一个工作流:先让一个智能体识别全部事实论断,再为每一项论断创建子智能体,逐一深入核查。你还可以让另一个核验智能体检查查找来源的子智能体,确保来源质量足够高。
排序
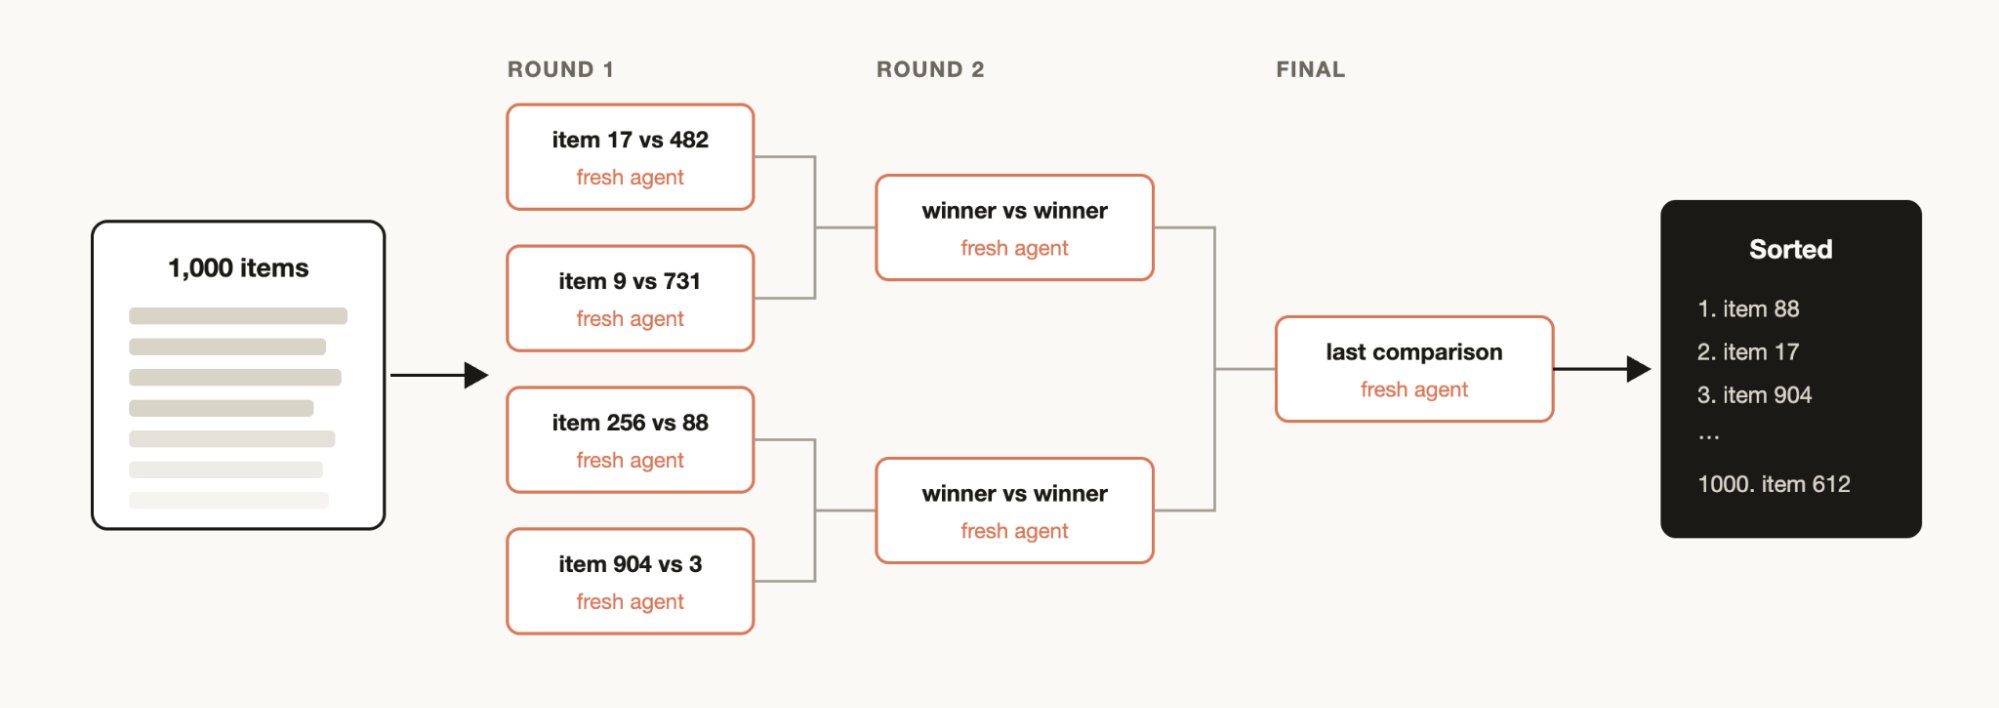
你可能有一份清单,希望按照某种定性标准进行排序,而你认为 Claude Code 擅长评估这种标准,例如按照缺陷严重程度给支持工单排序。但如果试图在一条提示词中对 1,000 多行数据排序,质量就会下降,而且上下文也容纳不下。可以改用锦标赛、由两两比较智能体组成的流水线(相对比较比绝对打分更可靠),或先并行分桶排序,再合并结果。每次比较都由独立智能体完成,确定性的循环负责维护对阵结构,上下文中只需保留当前的排序。
记忆与规则遵循
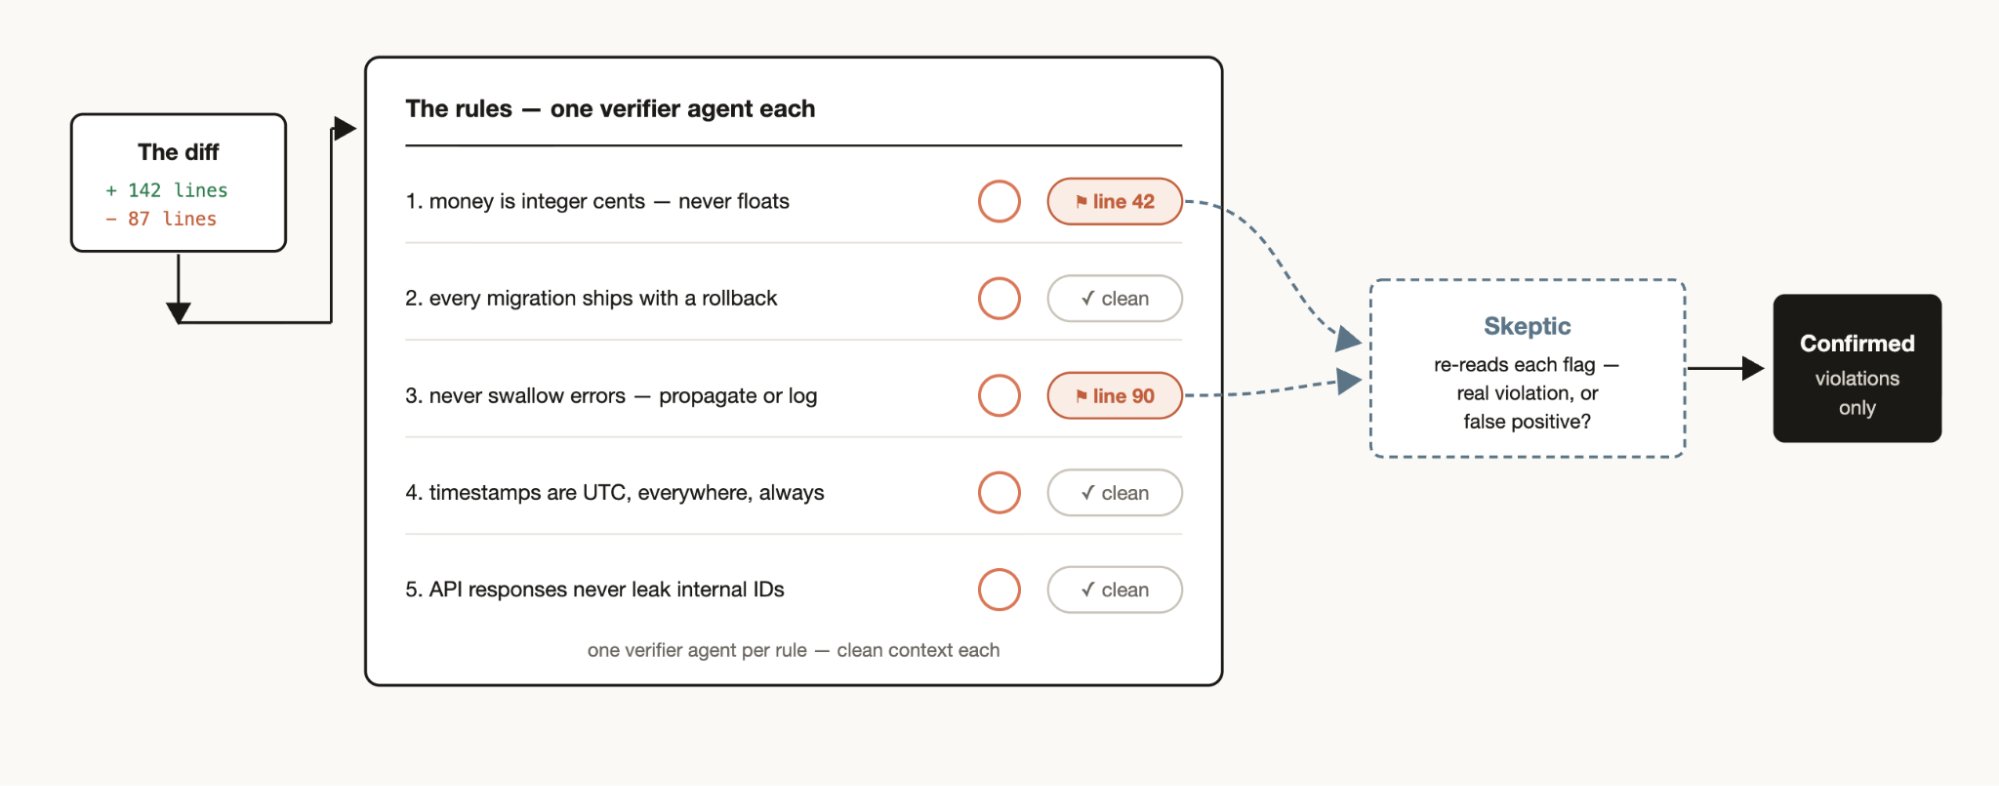
如果有一组规则,即使已经写入 CLAUDE.md,Claude 仍会遗漏或难以遵守,就创建一个工作流,列出必须由核验智能体检查的规则,每条规则对应一个核验智能体。再创建一个扮演怀疑者的子智能体,对规则检查进行复审,确认判断恰当,有助于减少误报。
反过来也可以这样做:从最近的会话和代码审查评论中提取你不断重复的纠正意见,让多个智能体并行聚类,对每条候选规则进行对抗式核验(这条规则真的能避免某个已经发生的错误吗?),最后把通过检验的规则提炼到 CLAUDE.md 中。
根因调查
调试最有效的方式,是提出几个彼此独立的假设,再逐一检验。但如果只使用一个上下文窗口,Claude 就可能偏爱自己的结论。工作流可以从结构上避免这一点:创建多个智能体,让它们分别根据互不重叠的证据生成假设,例如分别分析日志、文件和数据。然后,让每个假设都接受一组核验者和反驳者的审视。
这不仅适用于代码。工作流也可以用于销售分析(为什么三月份销量下降?)、数据工程(为什么这条流水线失败?),或任何事后复盘。
大规模分诊处理
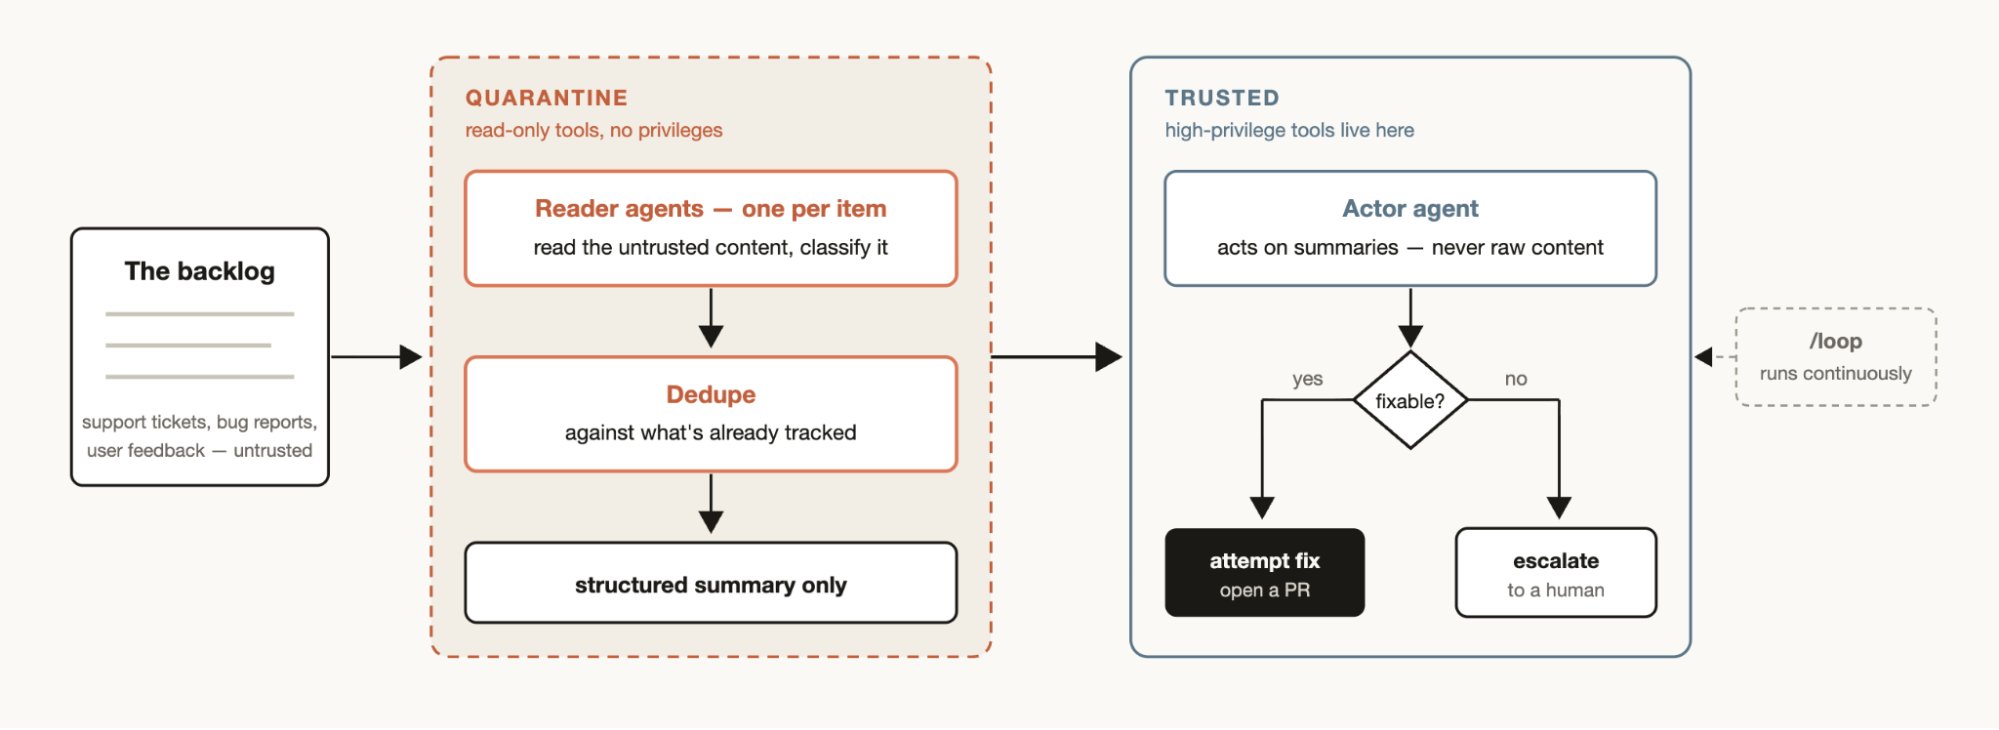
每个团队都有支持队列、缺陷报告,或其他无法完全靠人工处理的积压事项。
分诊工作流会对每个事项进行分类,与已有跟踪事项比对去重,然后采取行动。行动可能是尝试修复,也可能是升级给人工处理。
这类工作流中一个实用的模式是隔离:禁止读取不可信公开内容的智能体执行高权限操作,把这些操作交给专门负责根据信息采取行动的智能体。
将分诊工作流与 /loop 搭配,就能让 Claude 持续执行这些工作。
探索与审美判断
当你需要探索解决问题的不同方法时,工作流会很有帮助,尤其是设计、命名这类依赖审美与品味,并且适合用明确标准来评估的任务。
可以让 Claude 探索多个方案,再向评审智能体提供一套标准,说明什么样的方案才算优秀。当评审智能体认为方案已经满足标准时,任务就完成了。也可以按照这些标准,通过锦标赛对方案排序或作出选择。
评估
你可以为特定任务进行轻量评估:在 worktree 中创建独立智能体,再创建比较智能体,依据评判标准,对具体输出进行比较和评分。例如,按照特定标准评估并改进你创建的技能。
模型与智能水平路由
创建一个针对你的任务调校的分类智能体,由它决定使用哪个模型。如果任务需要大量工具调用,而且执行前的调研有助于判断哪个模型最适合,这种做法就很有价值。
例如,对于“解释身份验证模块如何工作”这个任务,最适合的模型取决于模块中有多少文件,以及代码库的结构。分类智能体可以先做这项调查,再根据预计的复杂程度,把任务交给 Sonnet 或 Opus。
什么时候不该使用动态工作流
工作流还是新事物。虽然它在许多场景下能带来显著效果,但并非每项任务都需要,而且可能消耗多得多的 token。
最好创造性地使用工作流,尝试让 Claude Code 完成过去没有尝试过的工作。对于常规编程任务,可以先问问自己:它真的需要更多计算资源吗?例如,大多数传统编程任务并不需要一个由五名评审者组成的评审团。
构建动态工作流的技巧
提示词
在动态工作流的提示词中写清细节,并采用上文介绍的具体技巧,通常能获得最佳结果。
工作流不只适用于大型任务。你也可以让模型使用一个“快速工作流”,例如,快速对某个假设进行一次对抗式审查。
结合 /goal 与 /loop
使用可以重复执行的工作流时,例如分诊、研究或核验,可以结合 /loop 按固定间隔运行,再用 /goal 设定必须达到的完成要求。
Token 使用预算
你可以为动态工作流明确设置 token 使用预算,限制任务消耗的 token 数量。例如,在提示词中写“使用 10k tokens”,就会设置相应上限。
保存与分享动态工作流
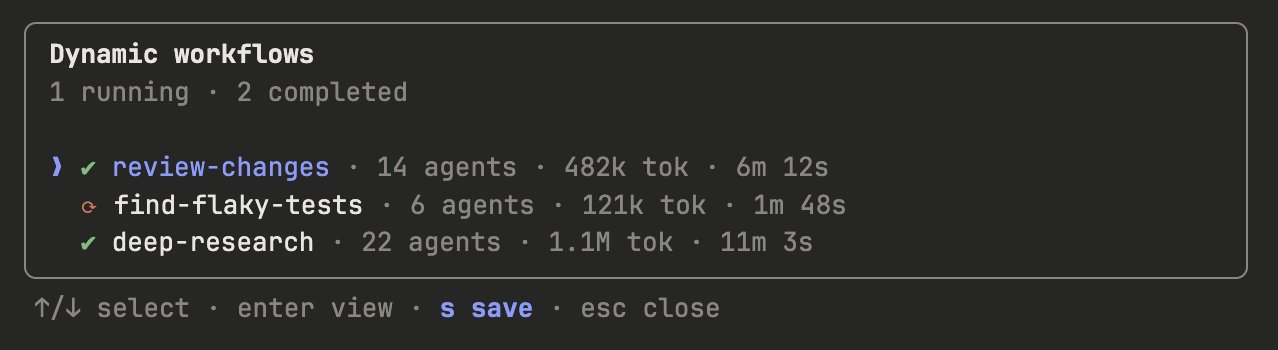
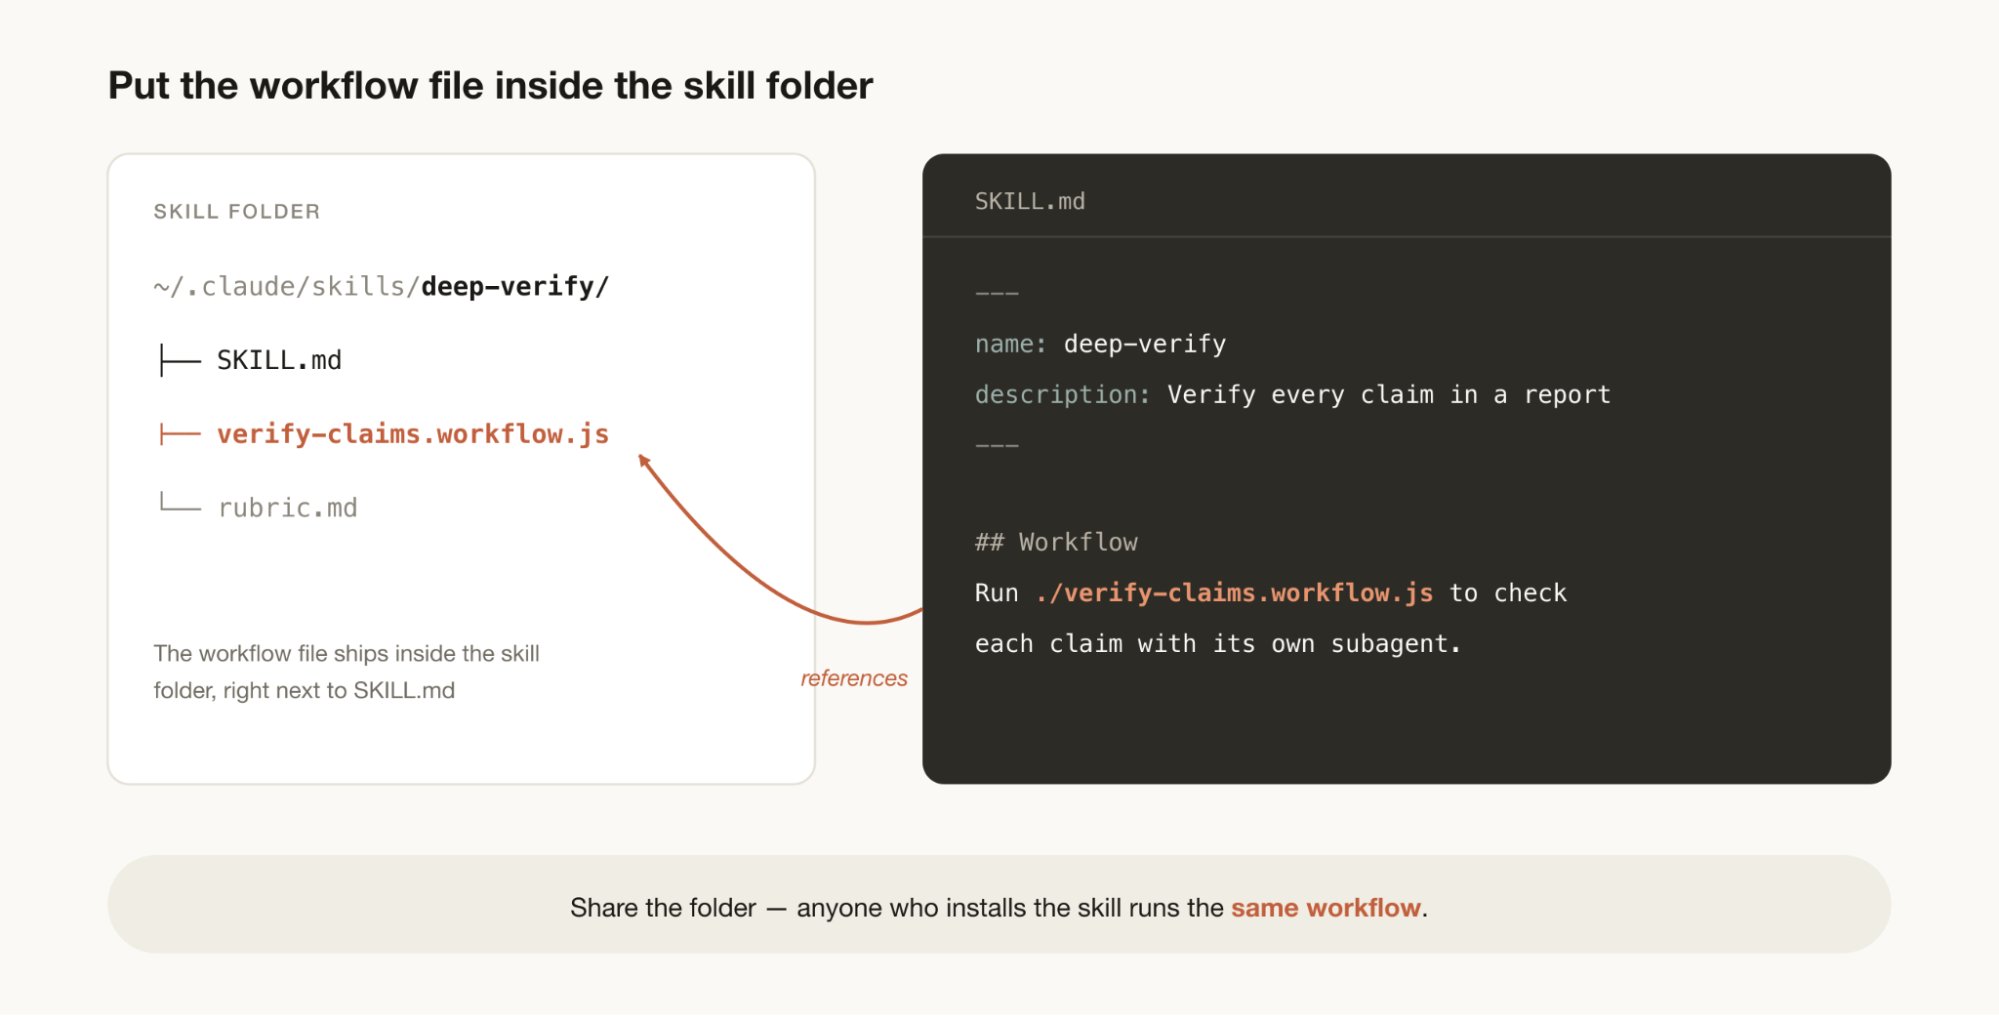
在工作流菜单中按“s”即可保存工作流。你可以把它们保存到 ~/.claude/workflows 中,或通过技能分发。
要通过技能分享工作流,将 JavaScript 工作流文件放入技能文件夹,并在 SKILL.MD 中引用它们。为了增加灵活性,你可以提示 Claude:把技能中的工作流视为模板,而不是必须原样执行的脚本。
一个全新的世界
工作流为扩展 Claude Code 提供了一种实用的新方式。我鼓励你把它当作一个起点,如何最好地使用它,还有许多值得探索的地方。欢迎告诉我们你的发现。
Thariq Shihipar 和 Sid Bidasaria(@sidbid)是 Anthropic 的技术团队成员,从事 Claude Code 的开发工作。
原文标题:A harness for every task: dynamic workflows in Claude Code
原文链接:https://x.com/trq212/article/2061907337154367865
0 条评论,59 次阅读